为什么 AI 漫画总让角色「变脸」?原因与解法
文字对一张脸的描述天然有损,所以每一格都在重新掷骰子。从根因讲到参考图工作流,说清楚角色一致性到底怎么守住。
 Lovecomic Team
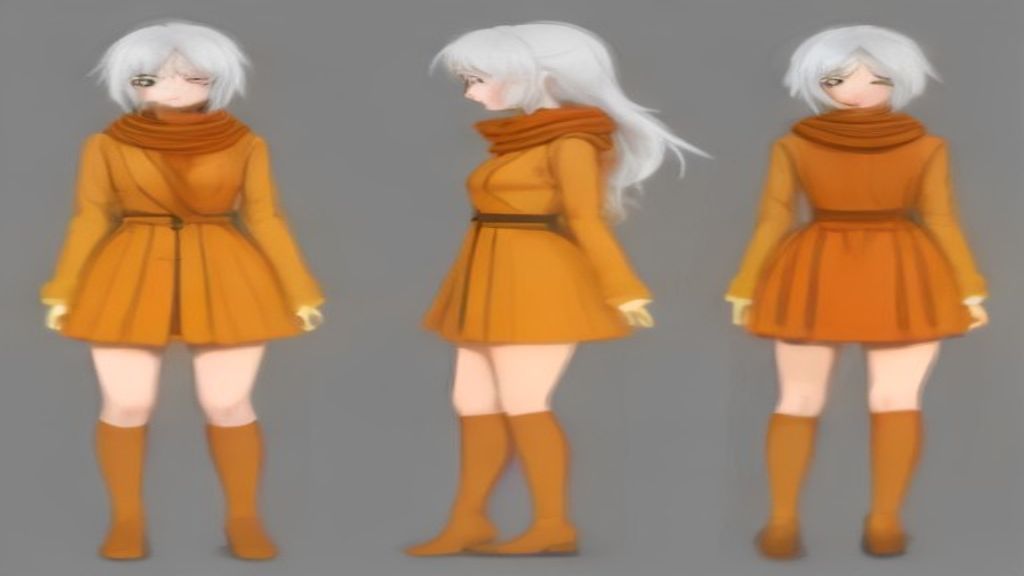
只要用图像模型生成过几格漫画,你就见过这个场面:第一格里,你的女侦探左颊有疤、大衣灰中带白、义眼泛着淡蓝光;到第四格,疤挪了位置或者干脆消失,大衣变成黑色,义眼变成了两只正常的眼睛。故事没变,角色变了。
这是 AI 漫画「看起来不对劲」的头号原因。它值得被认真解释一次——因为所有真正有效的解法,都来自同一个根因。
文字是一张脸的有损规格
先回到文生图模型的工作原理。它把一段随机噪声逐步变成图片,每一步都受你的提示词引导。提示词的作用是对一个「图片分布」做约束——它缩小了渲染范围,但并没有点名某一幅具体的图。「一个 25 岁、带机械义眼的侦探」对应着数百万张可能的脸。你的提示词选中的是一个街区,不是一栋房子。
对漫画来说,这带来一个直白的结果:每一格都是一次独立抽样。 除非给模型比文字更具体的东西,第四格只是恰好落在第一格附近的新一次掷骰子,而不是「同一个人」的再次渲染。这种漂移不是模型敷衍,而是信息论层面的限制——一句话承载不了精确指定一张脸所需的全部信息。从「一个有疤的女人」到「你的、带着你的那道疤的女人」,中间隔着的全是你没写出来、也写不出来的细节。
于是问题变成:有没有比描述更能承载「身份」的东西?
这条研究线是怎么解决的
这个问题已经有完整的研究脉络,结论也相当一致。
2022 年,Google Research 在 DreamBooth 论文里把问题说得非常准:文生图模型「缺乏复现给定参考集中主体外观、并在不同情境下合成其新形象的能力」。他们的方案是「个性化」——用某个主体的几张照片对模型做微调,让模型把该主体绑定到一个唯一标识上,之后就能在新的场景、姿态、光照下生成这同一个主体。方法有效,代价是每个角色都要跑一次训练。
一年后,腾讯 AI Lab 的 IP-Adapter 把同一件事变便宜了:不做微调,而是加一个轻量适配器(约 2200 万参数),采用「解耦交叉注意力」——一路注意力读你的文字提示,另一路读图像提示。图片本身成了指令的一部分。不再需要按角色训练,直接给模型看一张图,说「就是这个人,但换到这个场景」。
这就是对漫画最关键的那条洞见:范例图承载身份的能力远强于形容词。 到 2024–2025 年,这个能力进入了主流编辑类模型——Google 的 Gemini 图像模型(即「Nano Banana」系列)把「留住这个人,改掉其他一切」做成了消费级工具,多图参考输入成为一等能力。
放进漫画流水线里意味着什么
一话漫画是身份保持的最坏情况:同样几个角色,要在 4 到 12 格以上的画面里,以全新的姿态、角度、光照反复出现。实践中靠三件事守住——这也正是 Lovecomic 内置的三件事:
1. 每个角色一张定稿参考图(reference sheet)。 在画任何分格之前,每个常驻角色先固定一张参考图,锁定脸型、发型、服装和配色。你可以上传自己的照片来引导形象——但这个决定只做一次,不在每一格里反复重新协商。
2. 参考图跟着每一格走。 生成某一格时,上游的参考图会和该格描述一起作为图像输入传给模型。模型从来不是「凭记忆」画你的侦探,而是照着参考图画。这正是 IP-Adapter 的思路——用范例锁定身份——应用到每一帧。
3. 文字层面的指令同样冻结。 漂移有两种:人在漂,人周围的画风也在漂。每种画风都带有一组固定的绘制指令(线条、阴影、配色),注入到每一格的提示词里,所以锁住角色的时候,渲染风格也不会听天由命。彩色还是黑白,同样是项目级设定,不随单格重掷。
在这三条之外,流水线还有兜底:视觉 QA 环节会给生成的画格打分并列出可见问题;更关键的是,画格支持单独重绘。某一张脸漂了,就对着同一组参考图重掷这一格,而不是重做整话。
一份可执行的清单
如果你今天正在任何工具里和角色漂移搏斗:
- 一次性定死形象。 第一格之前先做参考图,不要边画边即兴。
- 控制角色数量。 每多一个常驻角色,参考图就要在每一帧里多钉住一个身份。
- 把服装当作身份。 服装、发型、配色是读者(和模型)认人的依据;用固定的说法描述它们,格与格之间绝不变化。
- 修格,不修话。 整话重掷会把已经对的部分一起重掷。只重画错的那一格。
- 如果一张脸怎么都锁不住,先重做参考图。 一张弱的参考图会毒害它下游的每一格。
一致性不是提示词技巧,而是工作流:定义一次、处处引用、局部修改。研究文献得出的也是同一个结论——只不过要把它变成日常,需要先造一条围绕它设计的漫画流水线。
参考来源
- Ruiz et al., DreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven Generation, Google Research, 2022, arxiv.org/abs/2208.12242。
- Ye et al., IP-Adapter: Text Compatible Image Prompt Adapter for Text-to-Image Diffusion Models, Tencent AI Lab, 2023, arxiv.org/abs/2308.06721。
- Google DeepMind, Gemini 图像模型("Nano Banana"):deepmind.google/models/gemini/image。